Hoofdstuk 5
Taalmodellen: wat zit er onder de motorkap van jouw generatieve AI-systeem?
29 min lezen
Taalmodellen (LLM’s) vormen het hart van generatieve AI-toepassingen. Maar wat zijn LLM’s en hoe verklaart dat, dat een prompt die je voert aan een taalmodel zorgt voor een respons van dat taalmodel die begrijpelijk is voor mensen.
#5.1Verschillende vormen van AI en hun samenhang
De term 'kunstmatige intelligentie' wordt vaak gebruikt als containerbegrip, maar in werkelijkheid omvat het een breed scala aan technologieën met uiteenlopende kenmerken en toepassingen. Om goed te begrijpen hoe generatieve AI werkt, is het daarom belangrijk om eerst het bredere landschap van AI in beeld te hebben. AI verwijst naar systemen die taken kunnen uitvoeren waarvoor normaal gesproken menselijke intelligentie nodig is. Denk aan redeneren, leren, plannen, herkennen van spraak of beelden, en zelfs het genereren van nieuwe inhoud zoals tekst of afbeeldingen (Russell & Norvig, 2016).
We maken meestal een onderscheid tussen drie hoofdcategorieën AI: symbolische AI, machine learning en generatieve AI. Symbolische AI, ook wel 'GOFAI' (Good Old-Fashioned AI of weak AI) genoemd, bestaat uit expliciete regels en logica. Een voorbeeld is een schaakprogramma dat alle mogelijke zetten via een boomstructuur doorrekent en daaruit de meest strategische keuze maakt. Symbolische AI volgt simpelweg vooraf geprogrammeerde regels of leert patronen op basis van data. Deze aanpak was dominant tot eind jaren tachtig (Crevier, 1993). Hierbij is er ook een verschil tussen zogeheten weak AI (zwakke AI) en strong AI (sterke AI). Strong AI is een hypothetisch concept waarbij een AI-systeem zou kunnen beschikken over een mensachtig bewustzijn en algemene intelligentie. Het wordt ook wel een algemene kunstmatige intelligentie (AGI) genoemd. Zo’n systeem zou niet alleen taken kunnen uitvoeren, maar ook kunnen redeneren, begrijpen, leren en zelfs emoties ervaren zoals een mens. Vooralsnog is dit nog toekomstmuziek, als het ooit al werkelijkheid wordt.
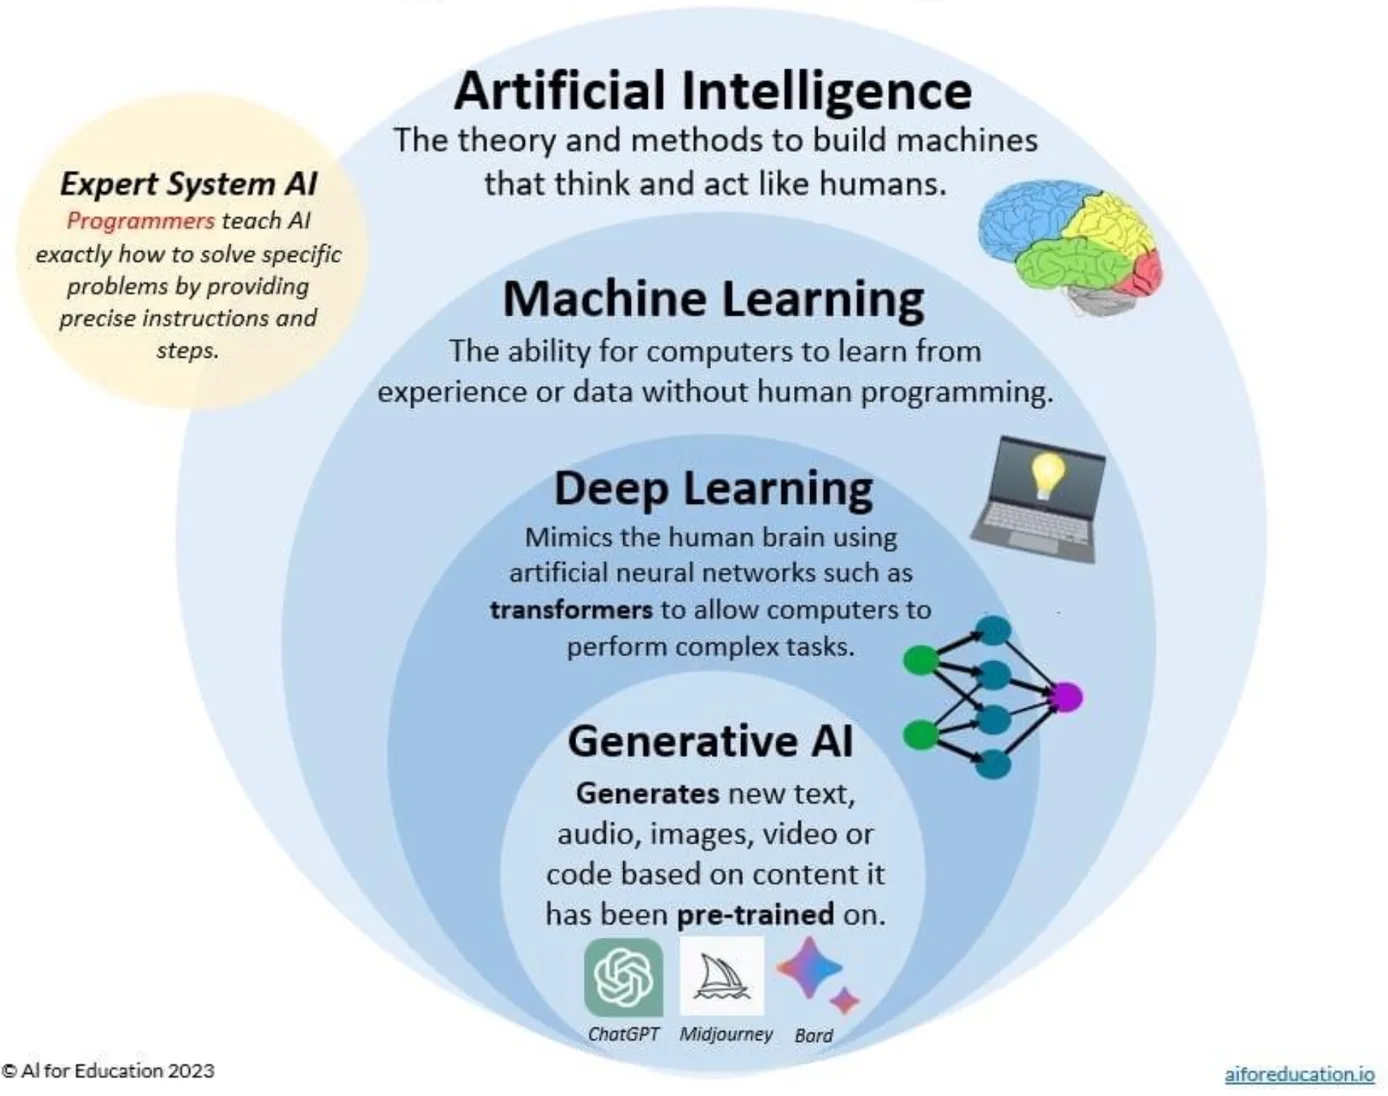
Met de opkomst van machine learning, een subcategorie binnen AI, veranderde de aanpak radicaal. In plaats van expliciet te programmeren hoe een systeem moet beslissen, leren modellen dit zelf te doen op basis van data. Hierbij werd het mogelijk om patronen in data te herkennen zonder menselijke tussenkomst bij elke stap. Machine learning maakt gebruik van statistische technieken zoals lineaire regressie en beslisbomen (T. M. Mitchell, 1997).
Een stap verder is deep learning, dat gebruikmaakt van kunstmatige neurale netwerken met meerdere lagen. Deze netwerken kunnen complexe patronen leren die eerder ontoegankelijk waren voor simpelere algoritmes. Denk hierbij aan het herkennen van objecten in afbeeldingen of het voorspellen van woorden in een zin. Deep learning vormt de ruggengraat van de meest geavanceerde AI-toepassingen die we vandaag gebruiken (LeCun et al., 2015).
Generatieve AI is een gespecialiseerde vorm van deep learning. In plaats van alleen classificeren of voorspellen, creëert generatieve AI nieuwe output: tekst, beeld, audio of video. Systemen zoals ChatGPT, DALL·E en Google Gemini zijn modellen die getraind zijn op enorme hoeveelheden gegevens en kunnen met die kennis originele inhoud genereren. Generatieve AI is dus niet alleen reactief, maar ook creatief: het schrijft gedichten, programmeert software, maakt kunstwerken en simuleert gesprekken (Bender et al., 2021). Maar dit doet een generatieve AI alleen op basis van jouw creatieve input, en de creatieve trainingsdata waarop het model is getraind. De output kan dus wel creatief zijn, maar is zelden origineel als je er zelf geen creatieve draai aan geeft.
#5.2Neurale netwerken en training
Na het verkennen van het AI-landschap, bekijken we de motor van generatieve AI: de neurale netwerken. Alles wat je ziet wanneer je een AI-model een tekst laat schrijven, een afbeelding laat genereren of een samenvatting laat maken, is het resultaat van wat zo’n netwerk heeft geleerd. Maar hoe leert een AI eigenlijk? En wat gebeurt er achter de schermen wanneer je een prompt invoert? In dit hoofdstuk ontdek je stap voor stap hoe een AI-model wordt getraind en hoe een neuraal netwerk functioneert.
#5.2.1Hoe werkt een neuraal netwerk?
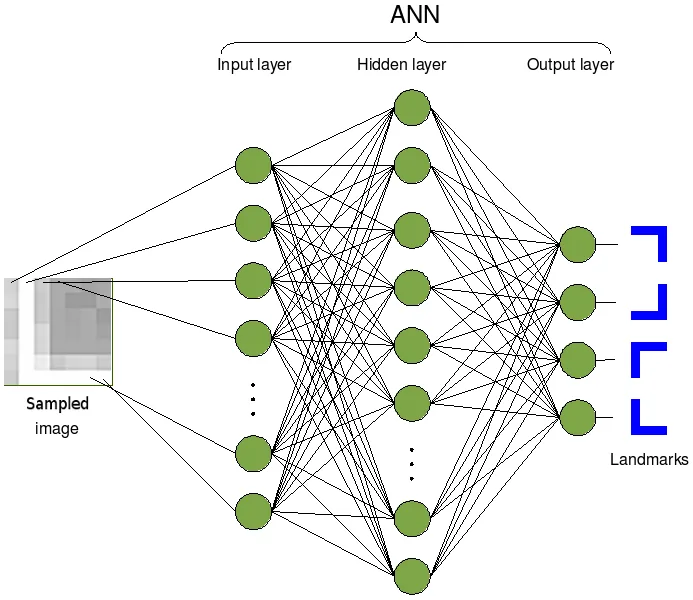
Een kunstmatig neuraal netwerk is geïnspireerd op het menselijke brein. Het bestaat uit lagen van ‘neuronen’ die informatie verwerken. Elke neuron neemt inputwaarden aan, voert een wiskundige berekening uit, en stuurt de uitkomst door naar de volgende laag. De verbindingen tussen neuronen hebben ‘gewichten’ die bepalen hoe belangrijk een bepaald signaal is. Door het aanpassen van deze gewichten leert het netwerk om steeds betere voorspellingen te doen.
Bij deep learning - de techniek waarop generatieve AI is gebaseerd - bestaan deze netwerken uit tientallen of honderden lagen. Elke laag herkent een iets abstracter patroon dan de vorige. Waar de eerste laag in een beeld bijvoorbeeld alleen randen of kleurvlakken herkent, kan een hogere laag een oog, gezicht of stoel onderscheiden (LeCun et al., 2015). Bij taalmodellen werkt het op een vergelijkbare manier: de eerste lagen herkennen individuele woorden, volgende lagen begrijpen grammaticale structuren of zelfs de toon en intentie van een tekst.
Een belangrijk onderdeel van generatieve AI is de zogeheten transformer, geïntroduceerd door Vaswani et al. (2017). Deze techniek bepaalt zelf welke woorden in een zin belangrijk zijn om de betekenis goed te begrijpen (zie paragraaf 5.2.3). Daardoor kunnen modellen zoals GPT-4 langere teksten analyseren en samenhangende antwoorden te geven. De T in GPT staat dan ook voor transformer.
#5.2.2Wat is machinaal leren?
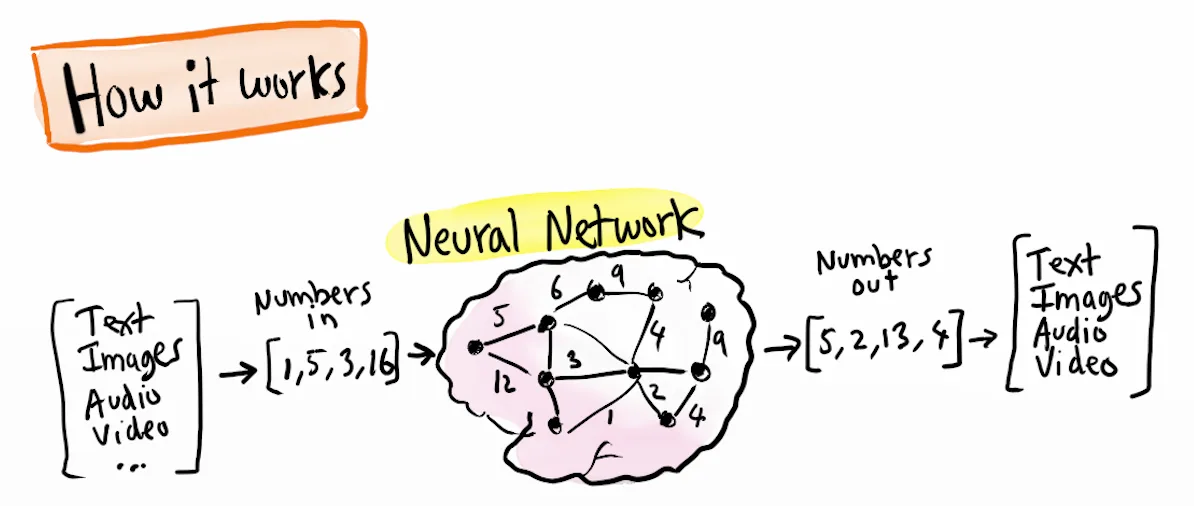
De volgende stap is om te begrijpen hoe neurale netwerken daadwerkelijk leren: dit proces noemen we machinaal leren. Machinaal leren (machine learning) is het proces waarbij computersystemen leren van voorbeelden. In plaats van expliciete instructies te programmeren, geven we het model een grote hoeveelheid gegevens als trainingsdata - bijvoorbeeld miljoenen teksten - en laten we het systeem zelf ontdekken wat de patronen zijn. Die trainingsdata zijn het fundament waarop het model leert wat bijvoorbeeld grammaticaal juist is, welke woorden vaak samen voorkomen, en hoe een bepaalde schrijfstijl klinkt (M. Mitchell, 2019).
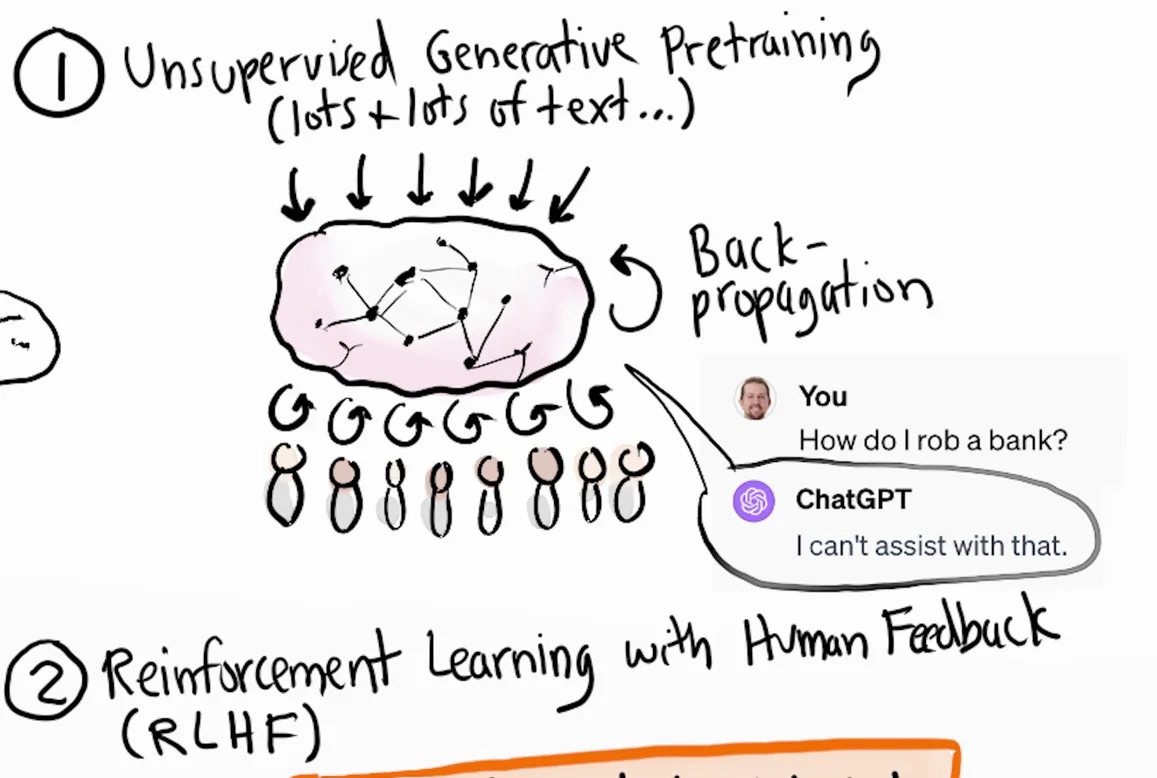
Dit leerproces is gebaseerd op trial-and-error. Het model doet een voorspelling (bijvoorbeeld: wat is het volgende woord in een zin?), krijgt te horen of het antwoord juist was, en past zichzelf aan. Deze foutcorrectie gebeurt met behulp van zogeheten ‘back propagation’: het rekenmodel stuurt een foutsignaal terug door het netwerk en past op basis daarvan de interne gewichten aan (Goodfellow et al., 2016).
#5.2.3Hoe leert een taalmodel door het volgende woord te raden?
Om te begrijpen hoe een taalmodel leert, kun je het vergelijken met een geavanceerde voorspellingsmachine die leert uit miljoenen voorbeelden. Het model krijgt tijdens de training zinnen te zien waarbij het telkens moet voorspellen wat het volgende woord is, compleet met waarschijnlijkheden.
Stap 1: De trainingszin
Stel, het model krijgt de zin: "De kat zit op de mat"
Stap 2: Het voorspellingsspel met kansen
Het model ziet eerst alleen: "De" Het voorspelt met kansen:
- "hond" (15% kans)
- "kat" (12% kans) ✓ juist!
- "man" (10% kans)
- "auto" (8% kans)
- ... en duizenden andere woorden met lagere kansen
Waarom is "hond" fout? Niet omdat honden niet bestaan na "De", maar omdat in deze specifieke trainingszin het juiste antwoord "kat" was. Het model leert nu dat het de kans op "kat" na "De" iets moet verhogen.
Stap 3: Het attention mechanisme - waar moet ik op letten?
Bij langere zinnen wordt het lastiger. Stel het model ziet: "De zwarte kat met de witte vlekken zit op de"
Het attention mechanisme helpt het model te 'onthouden' dat:
- "kat" het onderwerp is (niet "vlekken")
- "zit" de handeling is
- We waarschijnlijk een plek zoeken waar de kat op zit
Dit mechanisme geeft gewichten aan verschillende woorden. Het woord "kat" krijgt veel aandacht (0.8), terwijl "met" weinig aandacht krijgt (0.1).
Stap 4: Van training naar gebruik - de rol van temperatuur
Na training kan het model tekst genereren. Bij de zin "De kat zit op de" heeft het deze voorspellingen:
- "mat" (45% kans)
- "bank" (20% kans)
- "stoel" (15% kans)
- "tafel" (10% kans)
- "maan" (0.1% kans)
Hier komt het onderdeel temperatuur om de hoek kijken:
- Lage temperatuur (0.2): het model kiest bijna altijd "mat" - veilig maar saai.
- Normale temperatuur (0.7): meestal "mat", soms "bank" of "stoel" - natuurlijke variatie.
- Hoge temperatuur (1.5): kan zelfs "maan" kiezen - creatief maar mogelijk onzinnig.
Stap 5: Leren van miljarden voorbeelden
Na het zien van miljarden zinnen leert het model complexe patronen:
- "De minister-president kondigde aan dat..." → waarschijnlijk volgt beleid (70%)
- "De kat zit op de..." → waarschijnlijk een meubel of mat (85%)
- "Het onderzoek toont aan dat..." → waarschijnlijk wetenschappelijke conclusie (75%)
Het resultaat
Het model wordt een meester in het voorspellen van waarschijnlijke woordcombinaties. Het attention mechanisme helpt het om relevante context te 'onthouden' over langere afstanden in de tekst. Door de temperatuur aan te passen, kunnen we bepalen hoe 'veilig' of 'creatief' de output wordt.
Maar onthoud: het model ‘begrijpt’ niet echt dat katten dieren zijn. Het weet alleen dat in teksten waar "kat" voorkomt, vaak ook woorden als "miauwt" (65% kans), "muizen" (45% kans) of "staart" (40% kans) verschijnen. Dit verklaart waarom AI soms overtuigend kan klinken, maar toch feitelijk onjuiste dingen kan zeggen - het baseert zich op statistische patronen, niet op werkelijk begrip.
#5.2.4Verschillende manieren waarop AI getraind wordt
Bij supervised learning worden voorbeelden met labels gebruikt om patronen te leren herkennen (Hastie et al., 2009). Stel je voor dat je een computer wilt aanleren om te herkennen of een e-mailbericht spam is of niet. Dan geef je het systeem een grote verzameling e-mails, waarbij je bij elke e-mail een duidelijke label geeft: dit is spam, en dit is geen spam. Dit label helpt het algoritme om verbanden te leggen tussen kenmerken van de e-mail (zoals woorden, afzender, links) en het label.
Wie doet het werk?
Een datawetenschapper of machine learning engineer stelt het model op en verzamelt en labelt de data. Soms gebeurt het labelen handmatig, bijvoorbeeld door menselijke datalabelers. Als je duizenden of miljoenen voorbeelden nodig hebt, dan wordt dit vaak uitbesteed aan gespecialiseerde bedrijven. In hoofdstuk 9 gaan we in op de maatschappelijke aspecten hiervan.
Hoeveel tijd kost het?
Het bouwen van een goed werkend model kan weken tot maanden duren, afhankelijk van de grootte van de dataset, de complexiteit van het probleem, en hoe goed de data is voorbereid. Alleen het verzamelen en labelen van data kan al vele tientallen tot honderden uren kosten. Voor het maken van LLM’s of Vision modellen die afbeeldingen kunnen herkennen kan dit in de duizenden of zelf miljoenen uren lopen.
#5.2.5Unsupervised Learning - leren zonder voorbeelden
Unsupervised learning stelt systemen in staat om zonder vooraf gedefinieerde labels patronen te ontdekken (Bishop & Nasrabadi, 2006). Stel: je geeft een algoritme klantgegevens (zoals leeftijd, aankoopgeschiedenis en locatie), maar je zegt er niet bij wie trouwe klanten zijn of wie risicoklanten zijn. Het model moet dan zelf proberen om patronen te herkennen. Bijvoorbeeld: deze groep mensen komt vaak terug, en die groep maar één keer. Of: deze groep mensen stuurt vaker producten retour, en deze groep niet vaak.
Wie doet het werk?
Ook hier bouwen datawetenschappers het model en werken datalabelers aan de training. Het werk zit vooral in het verzamelen en opschonen van de data, het kiezen van geschikte algoritmes (zoals clustering of dimensionality reduction) en het interpreteren van de patronen.
Hoeveel tijd kost het?
Unsupervised learning kan sneller gaan dan supervised learning omdat je geen labels nodig hebt. Maar het interpreteren door datawetenschappers kost juist weer meer tijd, omdat de resultaten niet vanzelfsprekend zijn. Reken op enkele dagen tot enkele weken voor een gemiddelde analyse. Voor LLM’s of algemene vision modellen (modellen die zonder voorkennis afbeeldingen kunnen herkennen en genereren) loopt dit enorm op.
#5.2.6Reinforcement Learning - leren door beloning en straf
Bij reinforcement learning leert een systeem optimaal gedrag door interactie met een omgeving en feedback via beloningen (Sutton & Barto, 1998). Deze manier van leren lijkt een beetje op hoe mensen of dieren leren. Je laat de computer een taak uitvoeren (bijvoorbeeld een robot laten lopen of een spel laten spelen) en geeft een beloning als het goed gaat. Als het fout gaat, krijgt het geen beloning of zelfs ‘straf’. Op basis van die feedback leert het systeem wat werkt en wat niet.
Wie doet het werk?
Reinforcement learning wordt meestal uitgevoerd door gespecialiseerde AI-onderzoekers of engineers, omdat het technisch complex is. Het vereist vaak simulaties, veel rekenkracht (Graphic Processing Units - GPU’s), en ervaring met frameworks zoals OpenAI Gym, Unity ML, of TensorFlow Agents.
Hoeveel tijd kost het?
Dit is vaak het meest tijdrovend. Het trainen van een goed reinforcement learning-model kan dagen tot weken duren - soms langer - afhankelijk van de complexiteit van de taak. Denk aan honderden tot duizenden uren aan rekentijd en voorbereiding, inclusief het bouwen van de simulatieomgeving.
| Leermethode | Met of zonder labels | Wie voert het uit? | Gemiddelde tijdsinvestering |
|---|---|---|---|
| Supervised Learning | Met labels | Data scientists + datalabelingteams | Enkele weken tot maanden |
| Unsupervised Learning | Zonder labels | Data scientists | Enkele dagen tot weken |
| Reinforcement Learning | Feedbackgebaseerd | AI-onderzoekers / engineers | Weken tot maanden (enorme rekentijd) |
Het leerproces van een taalmodel verloopt hierbij technisch gezien in grofweg zes stappen:
- Tokenization. De invoer (tekst) wordt opgedeeld in kleinere eenheden: tokens. Dit kunnen woorden zijn, maar ook lettergrepen of zelfs losse tekens. Bijvoorbeeld de zin "De zon schijnt" wordt opgedeeld in: ["De", " zon", " schijnt"]. Opdelen kan op meerdere manieren, maar een vuistregel is dat 1 token ongeveer 3-4 letters groot is (CriticalMynd, 2025). Dit betekent dat bijvoorbeeld een blog van ongeveer 750 woorden wordt omgezet naar zo’n 1000 tokens, een essay van 3000 woorden naar ongeveer 4000 tokens en een boek van zo’n 750.000 woorden naar 1 miljoen tokens.
- Vectorisatie. Elke token wordt omgezet in een getallenreeks: een vector. Deze vector bevat informatie over de plaats van het woord in een taalruimte - vergelijkbaar met coördinaten op een kaart.
- Embedding. Alle vectoren worden gecombineerd in een zogeheten embedding space die de betekenisrelaties tussen woorden representeert. Woorden met vergelijkbare betekenissen komen dicht bij elkaar te liggen in deze ruimte.
- Training via backpropagation. Het netwerk leert door voorspellingen te doen en fouten te corrigeren. Als het bijvoorbeeld het woord “zon” voorspelt na “De”, en het juiste antwoord was “maan”, dan past het model de interne parameters aan om in de toekomst betere voorspellingen te doen.
- Loss-functies meten hoe goed of slecht een voorspelling is. Ze sturen het leerproces aan door te zeggen: “Je zat er 30% naast.”
- Fine-tuning is een extra trainingsfase waarin een al getraind model wordt aangepast aan specifieke taken of contexten - bijvoorbeeld juridische of medische toepassingen. Hierbij worden de gewichten in het model aangepast en ontstaat een kopie van het taalmodel.
#5.2.7Diffusion Models (Diffusers) - generatieve AI voor afbeeldingen
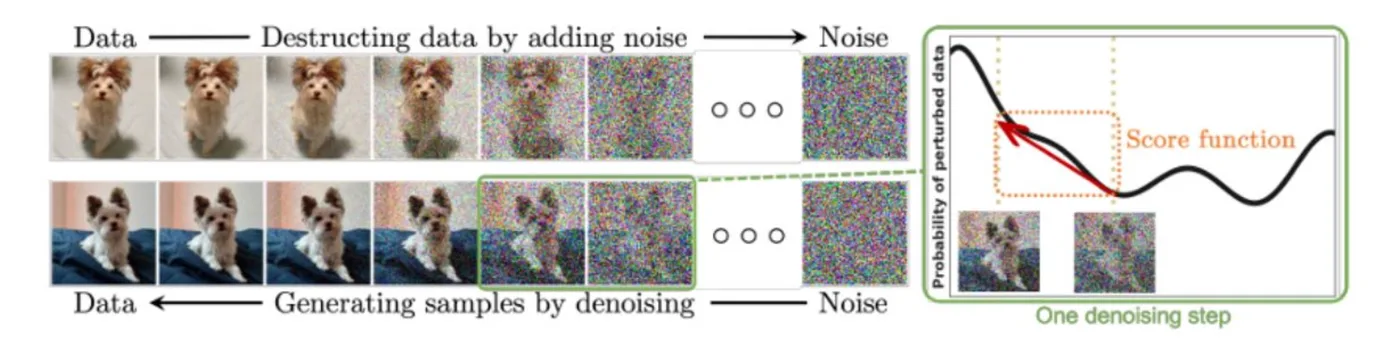
Een diffusion model wordt specifiek gebruikt voor het genereren van afbeeldingen. Diffusion models, zoals voor het eerst beschreven door Ho et al. (2020), zijn een type generatieve AI dat getraind wordt door geleidelijk ruis toe te voegen aan een beeld- of geluidsbestand. Denk bij die ruis aan statische storing: elementen die niet in het originele beeld thuishoren, zoals vervorming of willekeurige kleuren. Deze toegevoegde ruis wordt ‘Gaussian noise’ genoemd, omdat het een normale verdeling volgt - een perfecte klokvormige curve.
In de trainingsfase wordt steeds meer ruis toegevoegd, totdat het bestand volledig onherkenbaar is. Aan het eind bestaat het beeld of geluid alleen nog uit ruis. Deze fase heet diffusie. Wat het model dan nog weet over het oorspronkelijke beeld zit alleen opgeslagen in zijn geheugen. Daarna begint het omgekeerde proces: het model probeert stap voor stap de ruis weer te verwijderen en zo het originele beeld zo goed mogelijk te reconstrueren. Deze reconstructiefase heet reverse diffusion. Het model gebruikt daarbij wat het eerder geleerd heeft over patronen en structuren in andere beelden. Door dit proces leert het model om nieuwe beelden te genereren die lijken op de structuren die het kent uit de trainingsdata.
Tijdens dit leerproces wordt het model telkens beter in het voorspellen van welke ruis is toegevoegd. Door het verschil tussen het oorspronkelijke beeld en de verstoorde versie te analyseren, leert het model welke patronen ruis zijn en welke tot het beeld behoren. Deze continue wisselwerking tussen ruis toevoegen en verwijderen vormt de kern van hoe diffusion models functioneren en leren. Hierbij wordt AI door datalabelers aangeleerd wat wel en niet goed is: bijvoorbeeld plaatsjes waarbij een hond 5 poten zou krijgen bij diffusion in plaats van 4 poten.
#5.3Bias en datakwaliteit
Een van de meest besproken en tegelijkertijd vaak verkeerd begrepen aspecten van AI is het risico op bias: systematische vertekeningen in de output van een AI-systeem die leiden tot ongelijkheid, misrepresentatie of zelfs discriminatie. AI lijkt op het eerste gezicht neutraal: het is 'maar een algoritme'. Maar in werkelijkheid zijn AI-systemen zo goed (of zo slecht) als de data waarmee ze zijn getraind. In deze sectie ontdek je hoe bias ontstaat, waarom het zo hardnekkig is, en wat je kunt doen om het te herkennen en te verminderen.
#5.3.1Oorsprong van bias in AI
Bias in AI ontstaat meestal niet door kwade opzet van ontwikkelaars, maar doordat bij de training van modellen datasets worden gebruikt die inhoudelijk scheef verdeeld zijn. Denk bijvoorbeeld aan een taalmodel dat vooral getraind is op Engelstalige teksten van Amerikaanse websites: dat model zal vooral goed presteren in Amerikaanse contexten, en wellicht moeite hebben met idiomen of culturele referenties uit andere werelddelen (Bender et al., 2021).
Een klassiek voorbeeld komt uit de medische wereld: een AI-model dat huidaandoeningen moest herkennen, presteerde slecht op mensen met een donkere huidskleur, omdat de trainingsdata voornamelijk bestonden uit foto’s van witte huid (Buolamwini & Gebru, 2018). Het probleem zat dus niet in het model zelf, maar in de representatie van de data waarmee het getraind was. Als de trainingsdata vooral mannen bevatten, of mensen uit een bepaalde inkomensgroep, of teksten van een bepaalde ideologie, dan zal het model die onevenwichtigheden overnemen in de output. Stel je doet een sociologisch onderzoek naar voorkeuren in popmuziek dan zijn je resultaten via een AI waarschijnlijk gekleurd. Dit komt doordat de data waarop de AI getraind is al een bepaalde bias bevat, bijvoorbeeld vooral westerse data.
AI-modellen zijn dus niet alleen technische systemen, maar ook een afspiegeling van de wereld waarin ze ontstaan zijn, met alle bijbehorende cultuur, politiek, vooroordelen en discriminatie (Crawford, 2021b).
#5.3.2Strategieën om bias te verminderen
Hoewel je bias nooit volledig kan uitsluiten, zijn er wel manieren om de impact ervan te beperken, zoals:
- Dataset-diversificatie: verzamel trainingsdata uit meerdere bronnen, met oog voor de representatie van diversiteit in gender, etniciteit, taal, regio, leeftijd en sociaaleconomische achtergrond.
- Bias-audits: voer systematische tests uit op de output van AI om na te gaan of bepaalde groepen systematisch benadeeld worden.
- Transparantie: documenteer hoe het model getraind is, welke data zijn gebruikt en welke keuzes daarin zijn gemaakt (Model Cards, datasheets).
- Menselijke controle: laat gevoelige beslissingen - zoals in selectieprocedures of gezondheidszorg - altijd controleren door mensen.
#5.3.3Representativiteit en verantwoording
Een belangrijke vraag is: voor wie is het model bedoeld, en wie blijft buiten beeld? AI wordt vaak ontwikkeld in Silicon Valley, maar gebruikt over de hele wereld. Zonder expliciete aandacht voor context kan dit leiden tot toepassingen die culturele verschillen niet respecteren, of zelfs schadelijke gevolgen hebben. Denk aan automatisch gegenereerde beelden die stereotypen bevestigen, of samenvattingen die bepaalde perspectieven weglaten.
Een verantwoord gebruik van AI betekent dus niet alleen technische precisie, maar ook maatschappelijke reflectie. Wie bepaalt wat als ‘normaal’ geldt in een dataset? Wie heeft toegang tot de technologie, en wie niet? En wie draagt de gevolgen van fouten?
Bias kan ontstaan in elk stadium: bij het verzamelen van data, het selecteren van features, het trainen van het model, of zelfs bij de interpretatie van de output.
#5.4AI-hallucinaties
Stel je vraagt aan een taalmodel wie de president van Frankrijk is. Je verwacht Emmanuel Macron als antwoord. Maar het model antwoordt: François Hollande. Of erger nog: Victor Hugo. Dit soort onjuiste of verzonnen antwoorden staan bekend als AI-hallucinaties. Het woord ‘hallucinatie’ wordt hier gebruikt omdat de AI feitelijke informatie lijkt te verzinnen op basis van wat plausibel klinkt, zonder dat die informatie daadwerkelijk waar is. In deze sectie ontdek je wat AI-hallucinaties zijn, waarom ze optreden, hoe je ze herkent en welke implicaties ze hebben voor het gebruik van generatieve AI.
#5.4.1Wat zijn AI-hallucinaties?
Een AI-hallucinatie is output die grammaticaal en stilistisch correct lijkt, maar feitelijk onjuist, misleidend of compleet verzonnen is (Maynez et al., 2020). Bij taalmodellen als ChatGPT betekent dit dat het model zinnen genereert die niet overeenkomen met de werkelijkheid, maar wel klinken alsof ze waar zouden kunnen zijn. Zo kan een chatbot een niet-bestaande wetenschappelijke studie citeren of een artikel samenvatten dat niet bestaat. Bij beeldgeneratoren zoals DALL·E kunnen hallucinaties leiden tot onlogische afbeeldingen met bijvoorbeeld een hand met extra vingers of niet-bestaande objecten.
Hallucinaties vormen een van de grootste uitdagingen voor de betrouwbaarheid van generatieve AI, vooral in contexten waarin feitelijke juistheid essentieel is, zoals wetenschappelijk schrijven, medische adviezen of juridische ondersteuning.
#5.4.2Waarom ontstaan hallucinaties?
Het fundamentele mechanisme van een groot taalmodel is gebaseerd op kansberekening. Het model voorspelt telkens welk token - een woord of een deel ervan - waarschijnlijk volgt op basis van alle voorgaande tokens. Dit proces, ook wel ‘next-token prediction’ genoemd, is puur statistisch. Het model weet niet wat waar is of wat bestaat; het weet alleen wat waarschijnlijk klinkt binnen de context (Brown et al., 2020).
Als de trainingsdata onvoldoende zijn op een bepaald onderwerp, of als de context van de prompt vaag is, kan het model verkeerde aannames maken. Soms verzint het bronnen, omdat het geleerd heeft dat een artikel met jaartal en auteursnaam een goede vorm is, zonder daadwerkelijk te controleren of dat artikel bestaat. Ook de zogenaamde temperatuurinstelling van het model - die bepaalt hoe creatief het model mag zijn - speelt hierin een rol: hoe hoger de temperatuur, hoe groter de kans op verrassende, maar onbetrouwbare output.
#5.4.3Gevolgen van hallucinaties
In academische of professionele contexten kunnen AI-hallucinaties ernstige gevolgen hebben. Een student die een niet-bestaande bron citeert, riskeert beschuldiging van fraude. Een arts die op AI vertrouwt voor een zeldzame diagnose, kan een verkeerde behandeling kiezen. Zelfs in creatieve contexten, zoals storytelling of design, kan hallucinatie problematisch zijn als de gebruiker een bepaald niveau van consistentie verwacht.
Daarom is menselijke tussenkomst altijd noodzakelijk: de gebruiker moet de informatie controleren, de bronnen nagaan en zich bewust zijn van de grenzen van het systeem. Chatbots zijn geen orakels, maar geavanceerde gokmachines. Zonder kritische blik kan hun output misleiden, ondanks een professionele of overtuigende toon.
#5.4.4Herkennen en omgaan met hallucinaties
Er zijn enkele strategieën om AI-hallucinaties te herkennen en ermee om te gaan:
- Controleer bronnen: vraag het model naar de exacte URL of DOI van een artikel. Verzonnen bronnen hebben vaak geen werkende link. Toch kan een bron wel echt zijn, ook als de link niet werkt. Vraag daarom vooral naar de titel, auteur, jaartal en publicatie, en zoek deze zelf op.
- Vraag om onderbouwing: laat de AI de redenering achter een bepaalde conclusie uitleggen. Vage of circulaire argumentatie is een waarschuwingssignaal.
- Gebruik fact-checking tools: combineer AI-output met tools zoals Google Scholar, Consensus, PubMed of Wikipedia om claims na te trekken.
- Verlaag de temperatuur: als je controle hebt over de instellingen van het model, verlaag dan de temperatuur om de output voorspelbaarder en feitelijker te maken.
#5.5De 'Black Box' van AI
Hoewel generatieve AI vaak indrukwekkend lijkt door het vloeiende taalgebruik en snelle reacties, blijven veel van de onderliggende processen onzichtbaar en moeilijk te doorgronden - zelfs voor de ontwikkelaars. Dit fenomeen staat bekend als het 'black box'-probleem. Een AI-model kan tot nauwkeurige voorspellingen komen of overtuigende teksten genereren, maar het is vaak niet duidelijk hoe of waarom het dat doet. In deze sectie duiken je dieper in de aard van deze ondoorzichtigheid, de pogingen tot verduidelijking, en de ethische en maatschappelijke implicaties ervan.
#5.5.1Waarom is AI zo ondoorzichtig?
De complexiteit van moderne neurale netwerken is moeilijk te overschatten. Modellen zoals GPT-4 bevatten honderden miljarden parameters - gewichten en verbindingen tussen neuronen die samen het gedrag van het model bepalen (OpenAI, 2021). Wanneer je een prompt invoert, worden er duizenden berekeningen uitgevoerd in fracties van seconden. Elk van deze berekeningen draagt een klein beetje bij aan het eindresultaat, maar geen enkele individuele stap is op zichzelf beslissend. Hierdoor is het nagenoeg onmogelijk om te reconstrueren welke paden precies verantwoordelijk zijn voor de gegenereerde output.
Bovendien leren deze modellen via ‘terugvoering’ (back propagation) op basis van enorme hoeveelheden data. Ze internaliseren patronen zonder expliciete logica of regels te volgen. Het gevolg is dat ze functioneren als een soort complexe intuïtie: uiterst efficiënt, maar lastig uit te leggen. Dit gebrek aan transparantie staat controle, vertrouwen en verantwoording in de weg - zeker in contexten met hoge maatschappelijke risico’s zoals het vaststellen van een medische aandoening, het nemen van besluiten over toekennen van uitkeringen of toelating tot een opleidingen.
#5.5.2Pogingen tot uitlegbaarheid
AI lijkt misschien soms een mysterie voor je: er komt een antwoord uit, maar je weet niet hoe het tot stand kwam. Om dat 'black box’-gevoel tegen te gaan is het onderzoeksveld ‘explainable AI’ (XAI) ontstaan. Onderzoekers zoeken manieren om duidelijker te maken hoe een AI tot een besluit komt. Dat doen ze bijvoorbeeld door zichtbaar te maken waar het model in een tekst op let, of door een ingewikkeld model tijdelijk te vervangen door een eenvoudiger model dat beter te begrijpen is (Lipton, 2018).
Twee van de technieken hiervoor zijn bijvoorbeeld:
- SHAP (SHapley Additive exPlanations), dat probeert te bepalen welke inputfeatures het meeste hebben bijgedragen aan een bepaalde output.
- LIME (Local Interpretable Model-agnostic Explanations), dat het gedrag van een complex model lokaal benadert met een eenvoudiger, interpreteerbaar model.
Deze termen mag je hierna weer vergeten, maar wat wel belangrijk is om te onthouden, is dat dit soort methoden maar een beperkte blik geven. Ze geven een indruk van wat het model mogelijk heeft gedaan, maar geen sluitend bewijs. Bij taalmodellen zoals GPT is dit nog lastiger, omdat de invoer steeds verandert en de uitkomst afhankelijk is van lange contexten en kansberekeningen.
#5.5.3Ethische implicaties van ondoorzichtigheid
Het blackbox-karakter van AI roept fundamentele vragen op over verantwoordelijkheid en aansprakelijkheid. Wie is er verantwoordelijk als een AI-systeem een fout maakt - bijvoorbeeld een discriminerende beslissing in een sollicitatieprocedure of een foutieve medische aanbeveling? Als we niet kunnen uitleggen waarom een model iets doet, kunnen we het dan wel inzetten bij beslissingen die mensenlevens raken?
Cynthia Rudin (2019) betoogt dat in gevoelige domeinen zoals justitie, geneeskunde of kredietverstrekking geen black box-modellen gebruikt zouden mogen worden. In plaats daarvan pleit ze voor interpreteerbare modellen die weliswaar iets minder krachtig zijn, maar waarvan de werking begrijpelijk en toetsbaar is.
Bovendien leidt ondoorzichtigheid tot wantrouwen. Burgers, beleidsmakers en professionals willen begrijpen waarom een systeem tot bepaalde conclusies komt. Zonder uitlegbaarheid verliezen AI-systemen legitimiteit. Transparantie en uitlegbaarheid zijn dus geen luxe, maar voorwaarden voor maatschappelijk verantwoord AI-gebruik.
5.6Zelfstudievragen
5.6.1Checkvragen
- Wat is het verschil tussen supervised learning, unsupervised learning en reinforcement learning? Geef bij elk een kort voorbeeld.
- Wat zijn AI-hallucinaties en waarom ontstaan ze? Noem twee strategieën om hallucinaties te herkennen.
- Leg uit wat het 'black box'-probleem van AI is en waarom dit ethische vragen oproept.
5.6.2Reflectievragen
- In hoofdstuk 4 wordt beschreven hoe bias in AI-systemen ontstaat door scheef verdeelde datasets. Denk aan een concreet voorbeeld uit jouw eigen studiegebied waar dit problematisch zou kunnen zijn. Hoe zou je als toekomstig professional hiermee omgaan?
- Dit hoofdstuk vergelijkt het gebruik van AI met het besturen van een auto zonder te begrijpen hoe de motor werkt. In hoeverre vind je dat gebruikers van AI-systemen de onderliggende technologie moeten begrijpen? Wat zijn de voor- en nadelen van meer technische kennis voor gewone gebruikers?
- Door AI-gebruik, worden sommige woorden opeens een stuk vaker gebruikt. Zo valt het in het Engels op dat het woord ‘delve’ opeens veel vaker in teksten voor komt. Sommige mensen denken dat dit zou komen doordat bepaalde LLM's vooral getraind worden door mensen uit bepaalde gebieden. Zo zou het woord ‘delve’ gangbaarder zijn in Kenia, waar veel LLM's getraind worden. Wat denk jij? Beargumenteer je antwoord.
5.6.3Antwoordsuggesties
- Supervised learning gebruikt gelabelde voorbeelden om patronen te leren (bijvoorbeeld e-mails labelen als spam of geen spam). Unsupervised learning zoekt patronen zonder labels (bijvoorbeeld klanten groeperen op basis van koopgedrag). Reinforcement learning leert door beloning en straf (bijvoorbeeld een robot leren lopen door positieve feedback voor goede stappen).
- AI-hallucinaties zijn overtuigend klinkende, maar feitelijk onjuiste antwoorden die AI genereert. Ze ontstaan omdat AI statistisch voorspelt wat waarschijnlijk volgt, zonder echte kennis van feiten. Je kunt ze herkennen door bronnen te controleren, om onderbouwing te vragen, lagere temperatuurinstellingen te gebruiken, en fact-checking tools in te zetten.
- Het black box-probleem betekent dat we niet kunnen verklaren hoe AI tot specifieke beslissingen komt, ook al zijn de resultaten accuraat. Dit roept ethische vragen op over verantwoordelijkheid, transparantie en aansprakelijkheid, vooral in gevoelige domeinen zoals zorg of rechtspraak, waar uitlegbaarheid cruciaal is.
- Eigen reflectie gewenst. Denk bijvoorbeeld aan medische diagnoses die vooroordelen over bepaalde patiëntengroepen kunnen bevatten, of HR-systemen die discrimineren bij sollicitaties. Als professional kun je bewust zijn van deze risico's, diverse datasets eisen, regelmatig audits uitvoeren en altijd menselijke controle behouden bij belangrijke beslissingen.
- Eigen mening gewenst. Argumenten voor meer kennis: beter kritisch gebruik, meer vertrouwen, betere kwaliteitscontrole. Argumenten tegen: technische complexiteit is niet voor iedereen toegankelijk, focus moet liggen op praktisch gebruik. Een middenweg zou basisbegrip van mogelijkheden en beperkingen kunnen zijn zonder diepgaande technische details.