Hoofdstuk 6
Chatsoftware: een mooie verpakking rondom jouw LLM
13 min lezen
Een taalmodel op zich is niet bruikbaar voor eindgebruikers. Daarom wordt het taalmodel binnen een ander programma gebruikt om er mee te kunnen werken: vooral in chatprogramma’s maar ook overal waar een generatieve AI-functie in een al bestaand programma zit. Die programma’s draaien voor de eindgebruiker vaak in de browsers om het gemakkelijk te maken. Maar al het zware rekenwerk vindt plaats in datacenters.
#6.1Infrastructuur
Over het algemeen communiceer je via een chatinterface met AI-systemen die Large Language Models (LLM’s) bevatten. Deze technologie lijkt eenvoudig - je typt een vraag en krijgt een antwoord - maar achter de schermen is een complexe technische infrastructuur nodig. Veel mensen denken dat ze direct met een LLM praten en dat hun data alleen door het model wordt verwerkt en dat het model daar dan ook vanzelf door leert. In werkelijkheid verloopt alle communicatie via de chatinterface, die door een andere partij wordt beheerd. Hierdoor ontstaan misverstanden, bijvoorbeeld over:
- wie toegang heeft tot je data;
- of je data wordt gebruikt voor modeltraining;
- waar je data wordt opgeslagen en hoe lang.
Het is dus essentieel om het verschil te begrijpen tussen het LLM-bestand (het model) en de leverancier van de chatinterface (de tussenlaag, ofwel: de wrapper, de verpakking).
#6.2Het LLM is een groot bestand
Een LLM is één bestand dat je eventueel op je eigen computer zou kunnen zetten. Het bestand bevat miljarden parameters die zijn getraind op grote hoeveelheden data. Dit bestand bevat geen ingebouwde chatfunctionaliteit: het is een bestand dat, bij een bepaalde invoer (prompt), een enkele response genereert op basis van de GPT-methode (Generative Pretrained Transformer, zie Box 1.1 - Wat bedoelen we met ‘GPT’?). Het model zelf onthoudt niets van eerdere interacties; het is zogenaamd stateless. Het bestand heeft ook geen kennis van bijvoorbeeld de huidige datum (en platforms bieden aanvullende technieken en functies om die huidige datum of andere bronnen wel te ‘kennen’).
#6.3Chatinterface en chatgeschiedenis
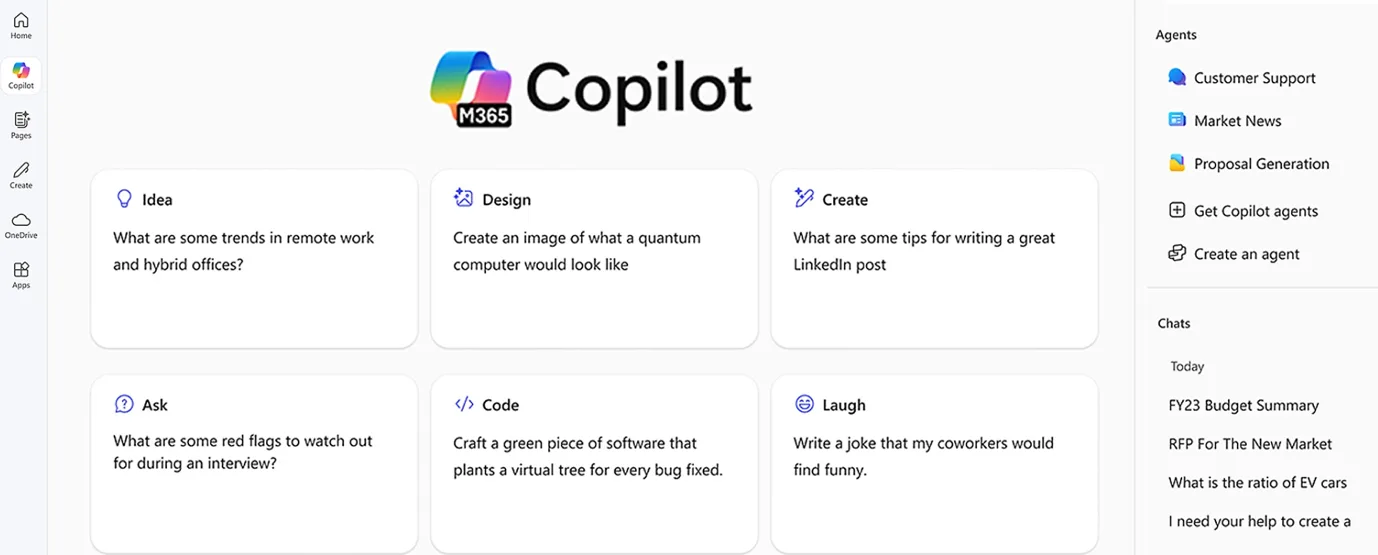
De ervaring van een doorlopend gesprek met een generatieve AI ontstaat door een tussenlaag: de chatinterface (bijvoorbeeld een webapp of app, denk aan Copilot, ChatGPT, Gemini, Claude).
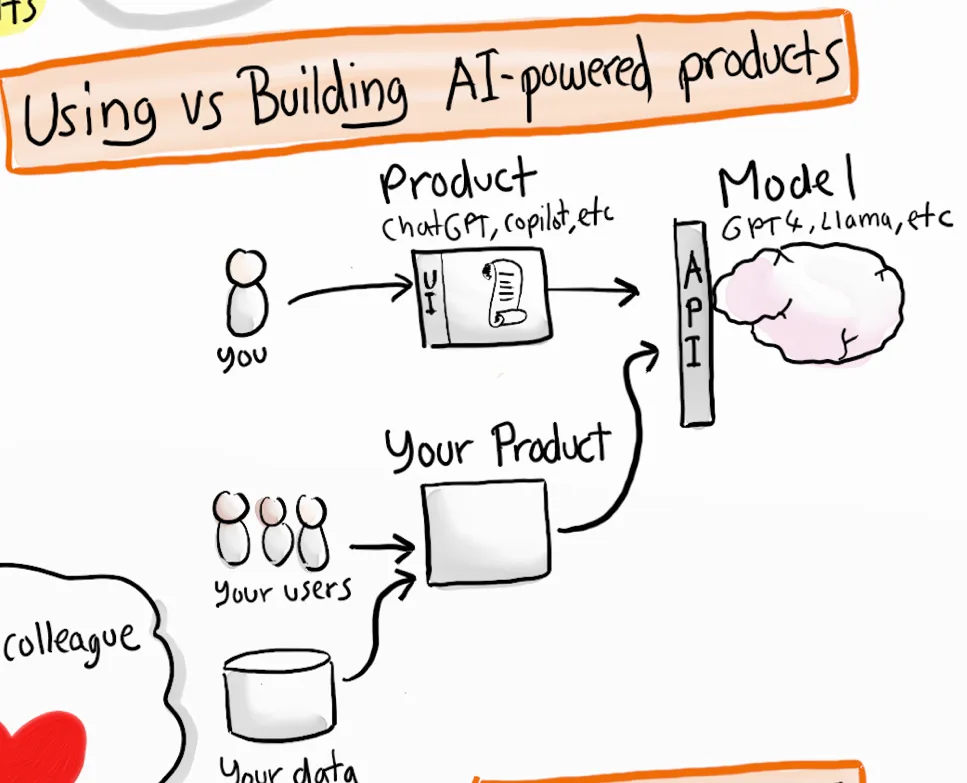
Deze Chatinterface bewaart de volledige chatgeschiedenis en stuurt bij elke nieuwe vraag de relevante chatgeschiedenis opnieuw mee naar het LLM-bestand. Dit heet conversational memory. Dit principe is ontstaan tezamen met de opkomst van LLM’s (Pinecone, 2025) en is essentieel voor het creëren van coherente gesprekken met AI.
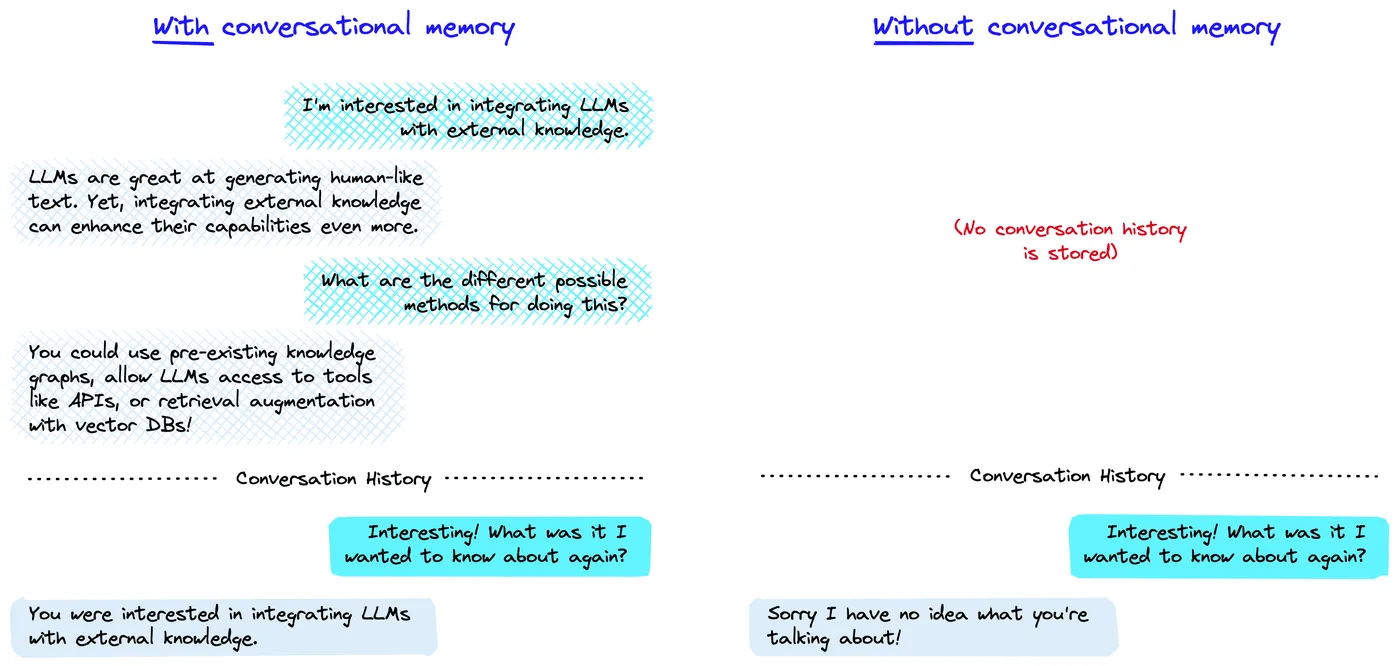
Het LLM ziet dus steeds het hele gesprek (of het deel dat past binnen de context window), waardoor het lijkt alsof het model een geheugen heeft en goed begrijpt wat je wil vragen. Want zonder de eerste vraag en het antwoord mee terug te sturen, weet het LLM dus niet waar het over gaat.
#6.4Geprepareerde chatbots en projecten
Met behulp van algemene chatomgevingen zoals Copilot en Gemini kun je ook geprepareerde bots maken. Zo kun je bijvoorbeeld een zogenaamde Custom GPT's maken: een vaste prompt, eventueel een kennisbron erbij, die je steeds opnieuw kunt gebruiken. Dat scheelt, want dan hoef je niet telkens opnieuw die instructies in te voeren en het zorgt voor meer consistente reacties van het taalmodel.
Daarnaast kun je in platforms als Gemini ook een project aanmaken (Gemini noemt deze Gems). Een project is een soort werkruimte waarin je bestanden, bronnen en regels samenbrengt. Binnen dat project reageert de AI steeds specifiek op die context, zodat je die niet telkens opnieuw hoeft in te voeren in een nieuwe chat binnen het project. Een bot legt vooral een rol of werkwijze vast (zoals “altijd antwoorden in academische stijl”), terwijl een project vooral gaat om het organiseren van je eigen materiaal en afspraken.
Een voorbeeld: wil je één document op verschillende manieren bevragen, dan maak je daar een GEmini Gem van en kun je meteen aan de slag. Als onderzoeker kun je in de instructies vastleggen uit welk domein het model vooral kennis moet halen en dat de antwoorden altijd referenties bevatten. Of, bij beeldgeneratie, kun je een vaste stijl beschrijven, zodat elke nieuwe afbeelding dezelfde look heeft. In een project kun je daarbovenop ook je bestanden en context bewaren, zodat je ze niet steeds opnieuw hoeft te uploaden.
Nog ter verduidelijking: Google noemt dit mechanisme van geprepareerde chatbots Gems, Anthropic noemt het Projects, Copilot noemt dit een Agents en EduGenAI noemt dit een Persona.
Ook in gewone programma’s zoals Word of Google Docs zie je steeds vaker zulke ingebouwde, geprepareerde bots terug. Vaak merk je dat niet eens: je gebruikt gewoon een menu-optie om tekst samen te vatten, te vertalen of om automatisch slides te maken op basis van een webpagina.
Op basis van de techniek kun je je ook voorstellen dat jijzelf of bedrijven zelf zo’n tussenlaag maken en aanbieden. Hieronder zie je een aantal voorbeelden.
| Leverancier | Product/tussenlaag | Modellen | Veilig voor VU Amsterdam? | Herkomst (Land, Continent) |
|---|---|---|---|---|
| SURF / Npuls | EduGenAI (waarschijnlijk beschikbaar januari 2027) | Mix van open source (zoals Mistral, LLaMA) en commerciële modellen (o.a. GPT-4, Claude) | Hoog | Nederland, Europa |
| Microsoft | Copilot for Web/ Bing Chat | GPT-4, GPT-4o (via OpenAI), met web browsing en multimodaliteit | Hoog (via SURF-licentie) | Verenigde Staten, Noord-Amerika |
| Microsoft | Copilot for Microsoft 365 | GPT-4 (via OpenAI), geïntegreerd in Word, Excel, Outlook, Teams | Niet beschikbaar voor VU | Verenigde Staten, Noord-Amerika |
| Google DeepMind | Gemini | Gemini 1.5 Pro, Gemini Flash (multimodaal, real-time web access) | Hoog (Google Workspace for Education) | Verenigde Staten, Noord-Amerika |
| Google DeepMind | Gemini Notebook | Gemini 1.5 Pro, Gemini Flash (multimodaal, real-time web access) | Hoog (Google Workspace for Education) | Verenigde Staten, Noord-Amerika |
| OpenAI | ChatGPT | GPT-3.5 (gratis), GPT-4, GPT-4o, GPT-5 (Plus), met DALL·E 3, Code Interpreter, Vision, Voice | Laag | Verenigde Staten, Noord-Amerika |
| Anthropic | Claude | Claude 2, Claude 3 Opus, Sonnet, Haiku (veiligheidsgericht, grote contextvensters - wil wel data gebruiken voor trainingsdoeleinden) | Middel | Verenigde Staten, Noord-Amerika |
| Mistral AI | LeChat | Mistral 7B, Mistral 8x7B (open source, Europees privacygericht) | Gemiddeld | Frankrijk, Europa |
| Proton | Lumo | Verschillende open source modellen. Proton presenteert zich als de meest privacy beschermde en Europese onlineomgeving | Hoog (hoewel geen overeenkomst met VU Amsterdam) | Zwitserland, Europa |
| DeepSeek | DeepSeek Chat | DeepSeek-V2, DeepSeek-Coder (gericht op wiskunde, programmeren, Chinees-Engels tweetalig) | Zeer laag | China, Azië |
| xAI | Grok | Grok-1, Grok-1.5, Grok-2 (multimodaal, real-time X/Twitter-integratie, 1M token context) | Zeer laag | Verenigde Staten, Noord-Amerika |
#6.5Agentic AI en Artificial General Intelligence
De toepassingssystemen van AI blijven zich ontwikkelen: in 2025 en 2026 vooral rond zogenaamde Agentic AI. Daarnaast wordt er veel gesproken over de ontwikkeling van zogenaamde Artificiële Algemene Intelligentie.
#6.5.1Wat is Agentic AI?
Agentic AI verwijst naar combinaties van prompts en zoekmechanismen die problemen kunnen doordenken, beslissingen kunnen nemen en acties kunnen ondernemen met minimale menselijke begeleiding. In tegenstelling tot reguliere generatieve AI die simpelweg reageert op prompts, gedraagt Agentic AI zich meer als een autonome assistent. Deze systemen gebruiken LLM's om te redeneren, hebben toegang tot externe tools (zoals zoekmachines of databases - of je eigen bestanden) en beschikken over geheugen om te leren van eerdere ervaringen. Zie het als het verschil tussen een rekenmachine die alleen berekent wat je invoert versus een studiepartner die je complexe opdracht kan opdelen in stappen, informatie online kan opzoeken, zich kan herinneren wat de vorige keer werkte, en de aanpak kan aanpassen als iets niet lukt.
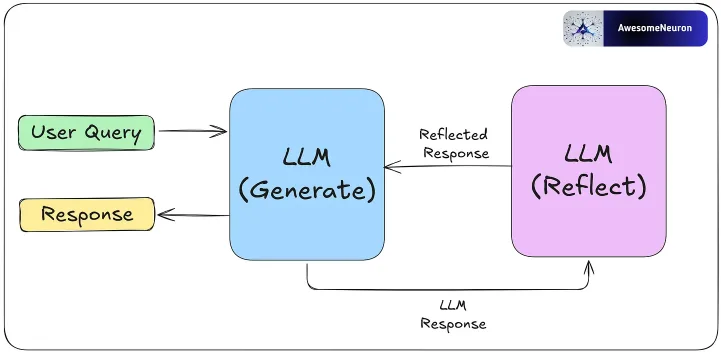
Als je bijvoorbeeld een agentische AI zou vragen om te helpen met het oplossen van fouten van je programmeeropdracht, zou het niet alleen een oplossing voorstellen, maar ook de fout analyseren, mogelijke oplossingen testen, leren van mislukkingen, zelf tussentijds extra code schrijven voor hulpfuncties en iteratief verbeteren totdat de code werkt (Herrman, 2026) (en het houdt alle documentatie automatisch bij). Maar agentische AI kan ook gekoppeld worden aan je e-mailprogramma, elektronische agenda en bestanden op je computer, zodat je daar ook direct iets mee kan gaan doen zoals automatisch afspraken inplannen of reageren op e-mails. Een ander voorbeeld is hoe de AI-gedreven wetenschappelijke literatuurzoekmachines werken. Hoewel dit hen ontzettend krachtig maakt voor het aanpakken van complexe, meerstapsoplossingsroutes, zijn ze niet altijd noodzakelijk. Voor eenvoudige taken zijn traditionele AI-chat- methodes sneller en goedkoper.
#6.5.2Artificial General Intelligence (AGI)
Hedendaagse AI blinkt uit in specifieke taken zoals taalverwerking, beeldherkenning of het spelen van spelletjes. Maar Artificial General Intelligence (AGI) zou vooral over flexibele, generaliseerbare intelligentie beschikken die in staat is te redeneren over onbekende problemen, kennis over te dragen tussen domeinen en zich aan te passen aan volledig nieuwe situaties zonder aanvullende training. Of AGI werkelijkheid zal worden, is een veelbesproken vraagstuk in de technologie en wetenschap. Sommige onderzoekers geloven dat we het binnen decennia kunnen bereiken door de huidige benaderingen op te schalen of door fundamentele doorbraken, terwijl anderen betogen dat het ontdekkingen vereist die we nog niet hebben bedacht, of dat het misschien helemaal niet mogelijk is. De tijdlijn en haalbaarheid hangen af van onopgeloste vragen over bewustzijn, redeneren en of intelligentie puur uit berekeningsprocessen kan ontstaan, waardoor AGI tegelijkertijd een technische uitdaging, een filosofisch vraagstuk en een onderwerp is dat zorgvuldige overweging van de maatschappelijke implicaties vereist.
#6.6Data en privacy: wie beslist wat er gebeurt met jouw gegevens?
Leveranciers van chatinterfaces bepalen wat er gebeurt met jouw data en de gegenereerde antwoorden. De leverancier kan er bijvoorbeeld voor kiezen om:
- de chatgeschiedenis lokaal of in de cloud op te slaan;
- jouw data te gebruiken voor analyse, productverbetering of zelfs voor training van nieuwe modellen;
- data te delen met derden of juist expliciet te beschermen.
Dit beleid verschilt per aanbieder en is vaak niet helemaal transparant. Sommige interfaces bieden privacyinstellingen, andere niet. Daarom is het belangrijk om bovenstaande techniek te begrijpen en op basis daarvan inschattingen te maken, zoals:
- Werk je met een leverancier met onduidelijke voorwaarden en processen? Wees dan heel voorzichtig met de data die je uploadt en de vragen die je stelt. Zorg ervoor dat je nooit gevoelige gegevens deelt zoals persoonlijke gegevens of vertrouwelijke bedrijfsinformatie. Voorbeelden van dit soort leveranciers zijn ChatGPT ofAnthropic en veel kleinere leveranciers. Ook in andere gevallen zijn de voorwaarden vaak niet helder. Zoals bij een betaald account.
- Biedt de universiteit of je werkgever een chatomgeving aan en zijn er duidelijke afspraken dat de gegevens nooit gedeeld worden met partijen buiten de instelling? Dan kun je veel vrijer gebruikmaken van de chatomgeving, maar deel nog steeds geen gevoelige gegevens als het niet strikt noodzakelijk is. Voorbeelden hiervan zijn de Copilot-omgeving die de universiteiten gebruiken, bij de VU de Gemini functies de SURF EduGenAI omgeving of omgevingen die door Onderzoeksinstituten worden aangeboden in eigen beheer. Let op: login met je VU gegevens.
- Biedt de universiteit of werkgever geen omgeving aan of twijfel je over de afspraken met de leverancier? Kijk dan of je kan werken met een LLM die je op je eigen (krachtige) pc of laptop kan installeren en gebruiken via een lokaal programma (Local LLM’s). Voorbeelden van programma’s zijn Jan.ai, LM Studio (Google), Ollama.
Vaak blijft er toch veel vaag over hoe je gegevens verwerkt worden, daarbij spelen veel juridische en technische vraagstukken een rol. Voor meer achtergrond over de complexiteit rond eigenaarschap van door gebruikers gegenereerde data in AI-interacties verwijzen we je naar het werk van Metcalf & Crawford (2016).
6.7Zelfstudievragen
6.7.1Checkvragen
- Wat is het verschil tussen een LLM-bestand en de chatinterface die je gebruikt om met het model te communiceren?
- Hoe werkt 'conversational memory' en waarom lijkt het alsof een AI-model zich jouw eerdere berichten herinnert?
- Welke factoren moet je overwegen bij het kiezen tussen verschillende AI-leveranciers zoals OpenAI, Microsoft Copilot of EduGenAI wat betreft veiligheid en privacy?
6.7.2Reflectievragen
- Stel je uploadt een document met gevoelige informatie naar ChatGPT voor een studieopdracht. Welke risico's loop je en hoe zou je dit anders kunnen aanpakken?
- Veel studenten denken dat ze direct met een AI-model praten, maar in werkelijkheid gaat alles via een tussenlaag van een bedrijf. Hoe beïnvloedt dit jouw vertrouwen in en gebruik van AI-chatdiensten?
6.7.3Antwoordsuggesties
- Een LLM is eigenlijk één groot computerbestand dat je theoretisch op je eigen computer zou kunnen zetten. Het heeft geen ingebouwde chatfunctionaliteit en is 'stateless' - het onthoudt niets van eerdere gesprekken. De chatinterface is de tussenlaag (zoals de ChatGPT website of app) die de gesprekservaring creëert door de chatgeschiedenis op te slaan en bij elke nieuwe vraag de hele conversatie weer mee te sturen naar het LLM.
- Het LLM zelf heeft geen geheugen. De chatinterface bewaart de volledige chatgeschiedenis en stuurt bij elke nieuwe vraag de relevante context opnieuw mee naar het model. Dit heet 'conversational memory'. Hierdoor lijkt het alsof het model zich het gesprek herinnert, maar in werkelijkheid ziet het steeds het hele gesprek opnieuw.
- Je moet kijken naar factoren zoals: transparantie over wat er met je data gebeurt, of er verwerkersovereenkomsten zijn afgesloten door je instelling, waar de data wordt opgeslagen, of je data gebruikt wordt voor modeltraining, en of je gevoelige informatie kunt delen. EduGenAI via SURF en Copilot via je universitaire licentie zijn meestal veiliger dan directe commerciële diensten.
- Als je gevoelige informatie uploadt naar ChatGPT kan dit worden opgeslagen, geanalyseerd of gebruikt voor modeltraining door OpenAI. Je loopt het risico dat vertrouwelijke gegevens bij derden terechtkomen. Betere alternatieven zijn: de AI-omgeving van je universiteit gebruiken, lokale LLM’s installeren, of de gevoelige delen uit je document halen voordat je het uploadt.
- Deze kennis zou je bewuster moeten maken van de keuzes die je maakt. Je realiseert je dat bedrijven als OpenAI, Google of Microsoft bepalen wat er met je gesprekken gebeurt. Dit kan je motiveren om bewuster te kiezen voor systemen waar je instelling afspraken over heeft gemaakt, of om kritischer te zijn over welke informatie je deelt via commerciële chatdiensten.